Article de conférence : FeedType examine l’adaptation des retours d’IA au fil des révisions d’un texte
Norah Almousa, Shayan Peyghambari Oskoui, Raquel Coelho, Gayle Rogers, Xiang Lorraine Li, Diane Litman
Proceedings of the Artificial Intelligence in Measurement and Education Conference (AIME-Con): Full Papers
Résumé de 500 mots
Norah Almousa et ses collègues ont publié FeedType dans les actes d’AIME-Con, conférence tenue du 5 au 7 octobre 2026. Le corpus réunit 1 966 paragraphes issus de trois cours universitaires de rédaction. Il compare les retours des enseignants et de six modèles de langage avec trois stratégies de formulation des prompts. Sept catégories décrivent le contenu des retours. Les annotations automatiques ont été confrontées à des jugements humains. Les modèles couvraient la plupart des catégories, mais aucun ne reproduisait entièrement les adaptations des enseignants. Les analyses des versions du texte et des performances concernaient uniquement le cours de rédaction appelé composition. L’étude examine les retours, sans tester l’effet d’une intervention sur l’apprentissage.
Sa contribution est un moyen de demander sur quoi se concentre un commentaire et si cette orientation change de manière appropriée. Un système peut demander à plusieurs reprises des précisions même lorsqu’une autre réponse serait plus utile. Faire correspondre la répartition des catégories d’un enseignant ne prouverait pas en soi que chaque commentaire est exact ou utile. Les cours du benchmark, les choix d'annotations et les versions de modèles testés limitent également la distance dans laquelle les résultats peuvent aller au-delà du paramètre rapporté.
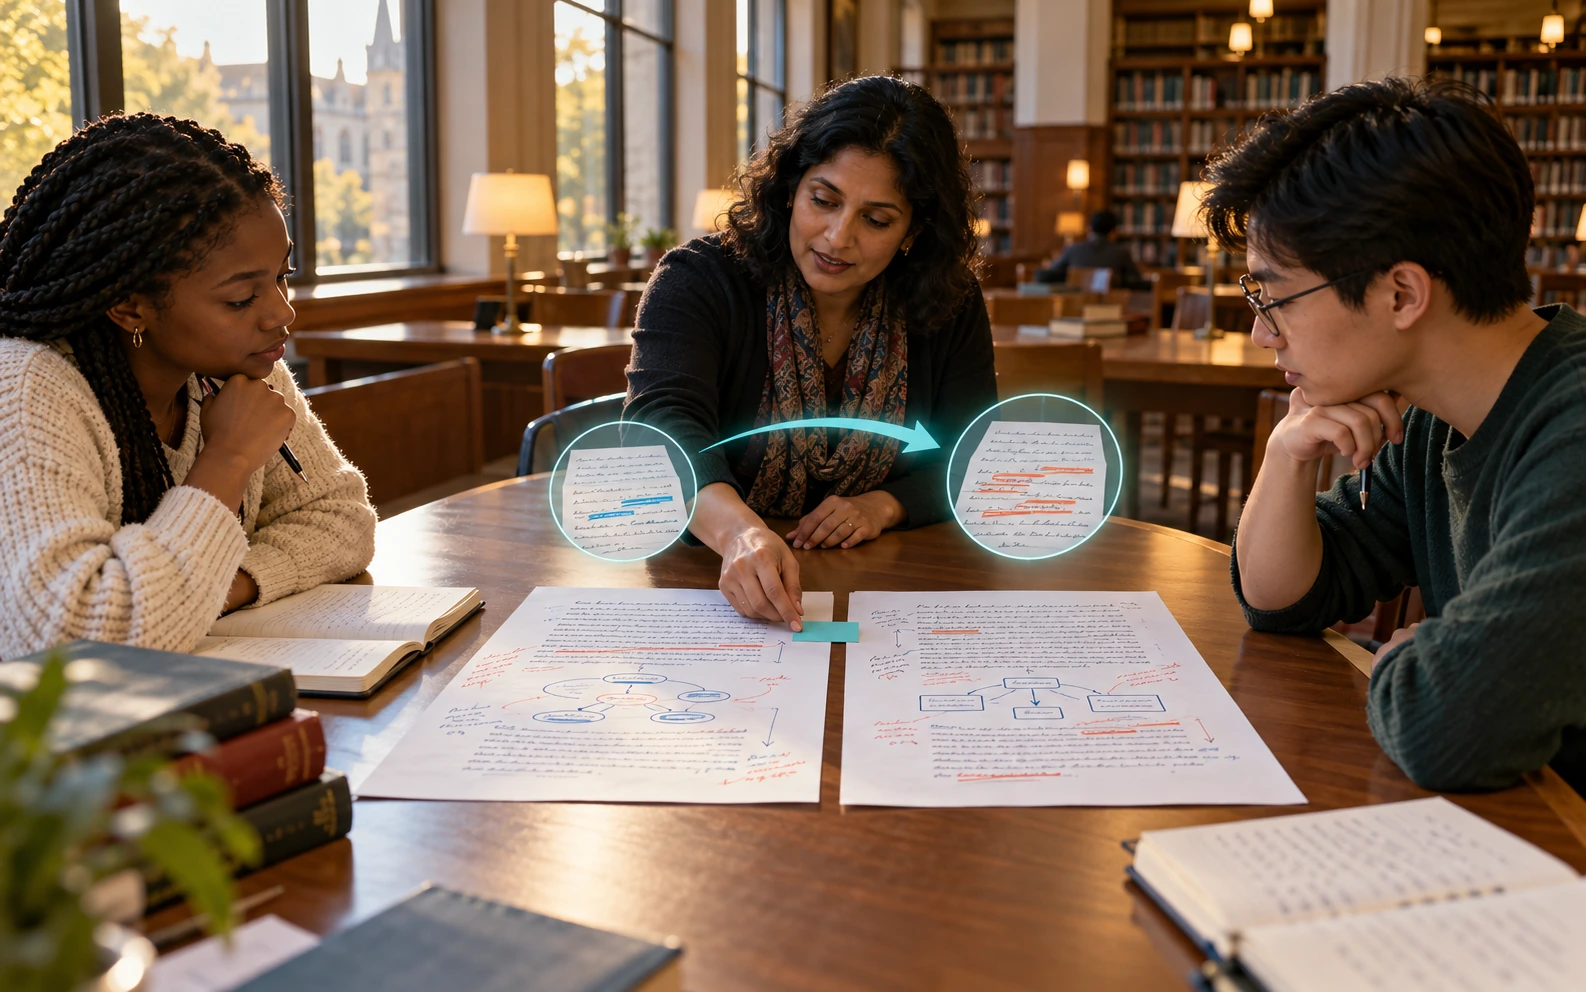
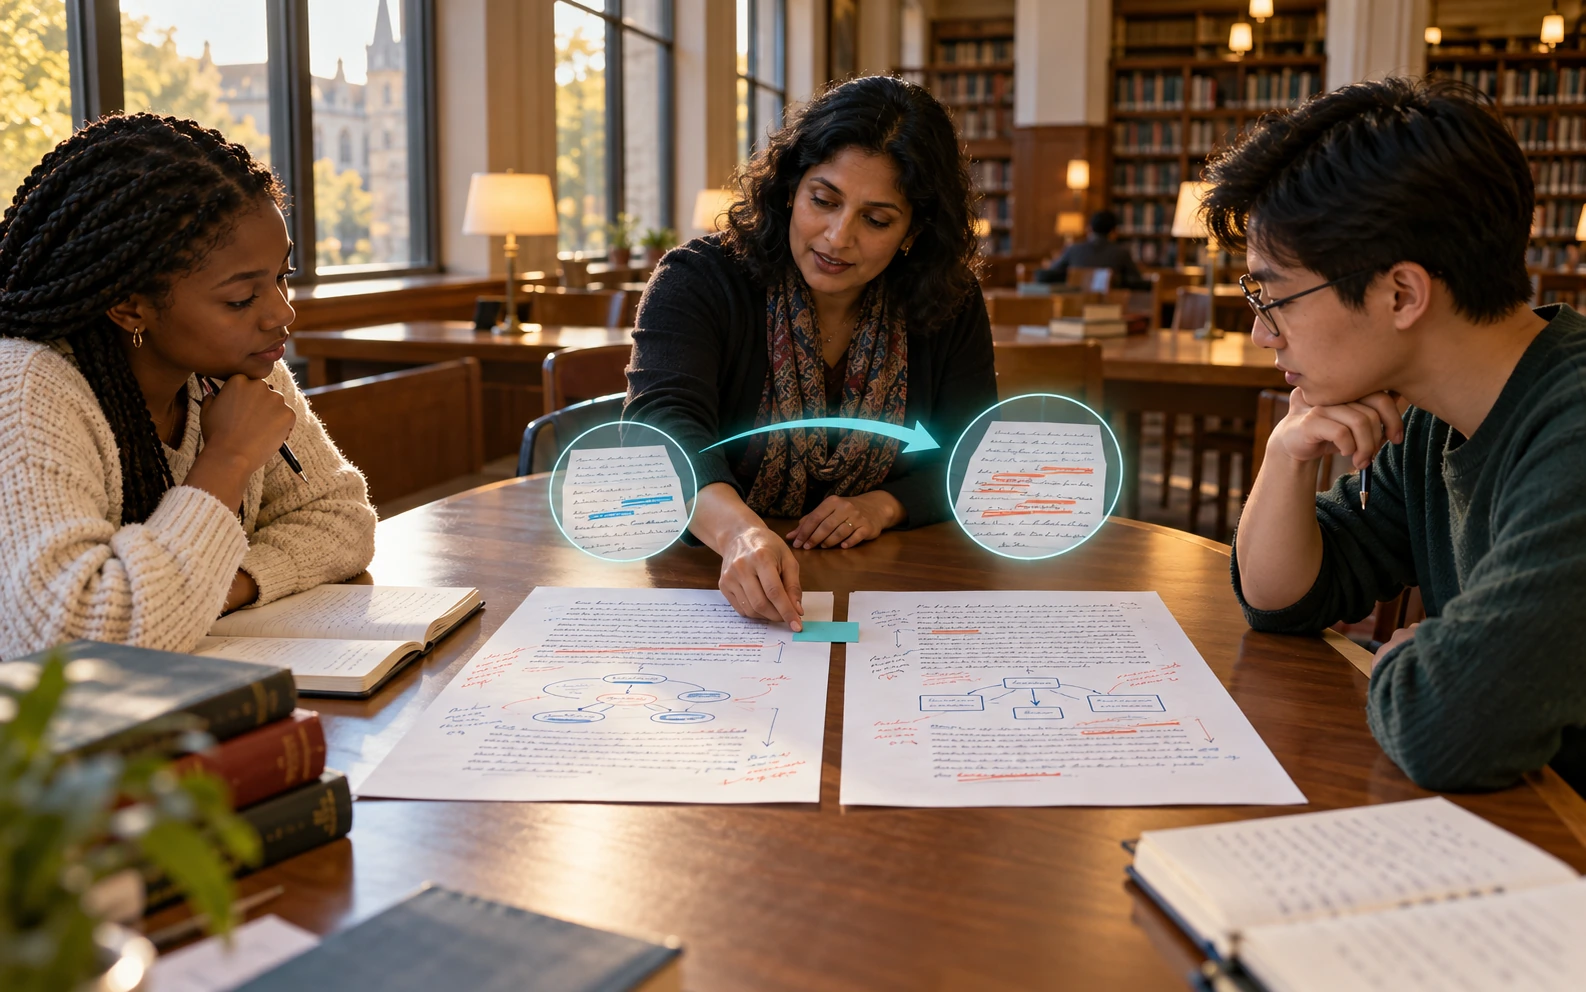
Pour l’AIEDHK, envisager une proposition d’atelier d’écriture construit autour de deux brouillons d’un même paragraphe. Avant de lire les commentaires générés, l'enseignant identifierait la prochaine étape la plus importante pour cette étape du devoir. Les élèves pourraient ensuite comparer les suggestions, localiser les preuves textuelles auxquelles chacune d’entre elles répond et expliquer quelle question mérite son attention en premier. Il s’agit d’une proposition pédagogique éditoriale, plutôt que d’une activité évaluée par l’étude de référence.
Par exemple, une première ébauche sur un problème environnemental local pourrait nécessiter une affirmation plus claire soutenue par une source appropriée. Un projet ultérieur pourrait déjà établir ce lien et nécessiterait plutôt une explication précise d’une qualification. Demander plus de détails dans les deux cas reviendrait à négliger les différentes priorités de révision. Les apprenants pourraient expliquer pourquoi un commentaire apparemment utile détournerait l’attention de la tâche en cours, donnant ainsi à l’enseignant la preuve de son jugement sur l’écriture.
Un pilote local pourrait conserver le brouillon, le commentaire suggéré, l’action sélectionnée par l’apprenant et une brève raison de ce choix. Les enseignants pourraient inspecter un petit échantillon d’accords et de désaccords plutôt que de supposer qu’accepter davantage de suggestions indique un meilleur apprentissage. Les évaluateurs doivent également examiner les commentaires qui identifient la bonne catégorie mais proposent un changement inapproprié. L’objectif serait de comprendre comment le feedback conforte une décision à un moment particulier d’un processus d’écriture.
Un cours d’écriture bilingue pourrait examiner si un commentaire préserve le sens voulu par l’auteur dans toutes les langues. Les élèves pourraient défendre une révision en utilisant l’objectif du devoir, tandis que l’enseignant se demande si le raffinement linguistique détourne l’attention d’un argument non résolu ou d’une affirmation non étayée.
Pour les équipes produit, l’étude propose une question d’évaluation qui peut être concrétisée avant le déploiement : le feedback répond-il à la mission, au brouillon en cours et à la difficulté démontrée par l’apprenant ? Cette question peut guider un ensemble de révisions limitées sans transformer le comportement antérieur de l’enseignant en une norme incontestable. Une écriture ultérieure réalisée avec moins d’assistance pourrait fournir des preuves d’apprentissage complémentaires. FeedType fournit une ressource de recherche utile pour examiner la rétroaction adaptative ; une décision d’adoption en classe ou dans un établissement a toujours besoin de preuves sur la qualité et les conséquences des commentaires réellement reçus par les apprenants.