Konferenzbeitrag: FeedType untersucht, wie KI-Schreibfeedback seinen Fokus bei Überarbeitungen anpasst
Norah Almousa, Shayan Peyghambari Oskoui, Raquel Coelho, Gayle Rogers, Xiang Lorraine Li, Diane Litman
Proceedings of the Artificial Intelligence in Measurement and Education Conference (AIME-Con): Full Papers
500-Wörter-Zusammenfassung
Norah Almousa und ihr Team veröffentlichten FeedType im Tagungsband der AIME-Con vom 5. bis 7. Oktober 2026. Der Benchmark umfasst 1.966 Absätze aus drei universitären Schreibkursen. Verglichen werden Rückmeldungen von Lehrenden und sechs Sprachmodellen unter drei Prompting-Strategien. Sieben Kategorien beschreiben den inhaltlichen Fokus. Automatische Annotationen wurden mit menschlichen Urteilen abgeglichen. Die Modelle deckten die meisten Kategorien ab, aber keines bildete die Anpassungsmuster der Lehrenden vollständig nach. Analysen der Überarbeitungsstufen und des Leistungsniveaus waren auf den Schreibkurs composition beschränkt. Untersucht wird das Feedbackverhalten; eine Wirkung auf das Lernen wurde nicht experimentell geprüft.
Sein Beitrag ist eine Möglichkeit zu fragen, worauf sich ein Kommentar konzentriert und ob sich dieser Fokus entsprechend ändert. Ein System kann wiederholt um eine nähere Erläuterung bitten, selbst wenn eine andere Antwort nützlicher wäre. Der Abgleich der Kategorienverteilung eines Lehrers allein beweist nicht, dass jeder Kommentar korrekt oder hilfreich ist. Die Kurse, Anmerkungsoptionen und getesteten Modellversionen des Benchmarks schränken auch ein, wie weit die Ergebnisse über die gemeldete Einstellung hinausgehen können.
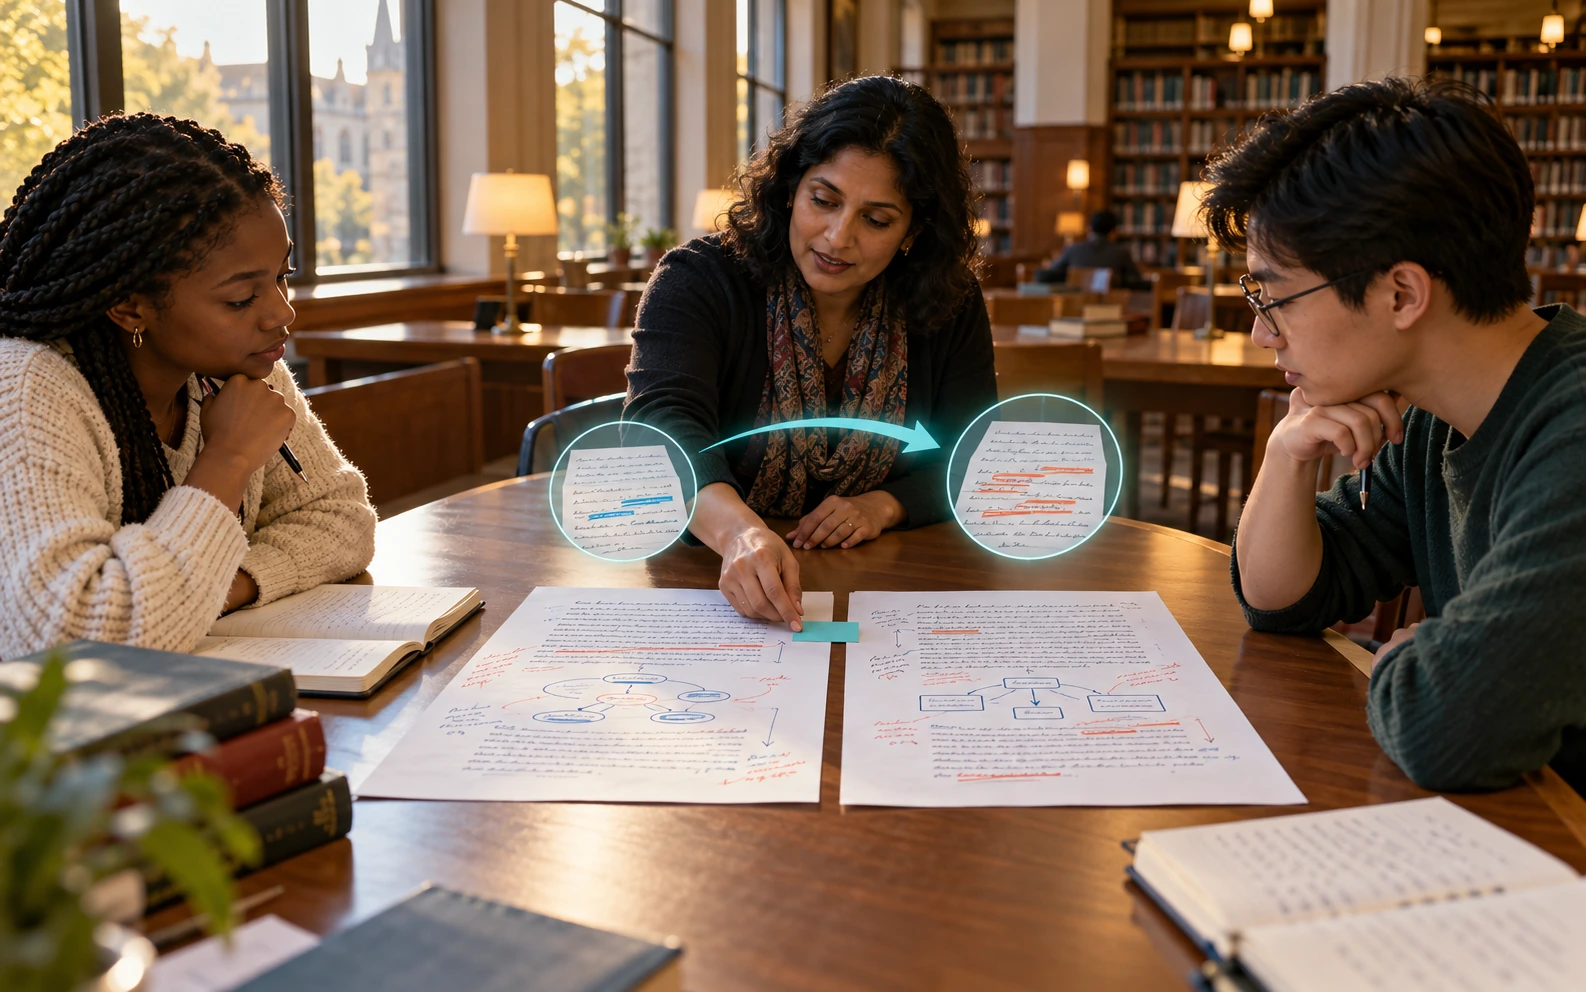
Erwägen Sie für AIEDHK einen vorgeschlagenen Schreibworkshop, der auf zwei Entwürfen desselben Absatzes basiert. Bevor der Lehrer das generierte Feedback liest, ermittelt er den folgenreichsten nächsten Schritt für diese Phase der Aufgabe. Die Schüler könnten dann Vorschläge vergleichen, die jeweils angesprochenen Textnachweise finden und erklären, welches Problem zuerst Aufmerksamkeit verdient. Hierbei handelt es sich um einen redaktionellen Lehrvorschlag und nicht um eine durch die Benchmark-Studie evaluierte Aktivität.
Beispielsweise könnte ein früher Entwurf zu einem lokalen Umweltproblem eine klarere Behauptung erfordern, die von einer geeigneten Quelle gestützt wird. Ein späterer Entwurf könnte diesen Zusammenhang bereits herstellen und stattdessen eine genaue Erläuterung einer Qualifikation erfordern. Würde man in beiden Fällen mehr Details verlangen, würden die unterschiedlichen Revisionsprioritäten außer Acht gelassen. Die Lernenden könnten erklären, warum ein scheinbar hilfreicher Kommentar von der aktuellen Aufgabe ablenken würde, und so dem Lehrer einen Beweis für ihr Urteil über das Schreiben geben.
Ein lokaler Pilot könnte den Entwurf, den vorgeschlagenen Kommentar, die vom Lernenden ausgewählte Aktion und einen kurzen Grund für diese Auswahl speichern. Lehrer könnten eine kleine Stichprobe von Vereinbarungen und Meinungsverschiedenheiten untersuchen, anstatt davon auszugehen, dass die Annahme weiterer Vorschläge auf besseres Lernen hinweist. Prüfer sollten auch Kommentare prüfen, die die richtige Kategorie identifizieren, aber eine ungeeignete Änderung vorschlagen. Der Zweck besteht darin, zu verstehen, wie Feedback eine Entscheidung zu einem bestimmten Zeitpunkt im Schreibprozess unterstützt.
Ein zweisprachiger Schreibkurs könnte untersuchen, ob ein Kommentar sprachübergreifend die beabsichtigte Bedeutung des Autors beibehält. Die Schüler könnten eine Überarbeitung unter Berufung auf den Zweck der Aufgabe verteidigen, während der Lehrer darüber nachdenkt, ob der sprachliche Schliff von einem ungelösten Streit oder einer nicht unterstützten Behauptung ablenkt.
Für Produktteams schlägt die Studie eine Bewertungsfrage vor, die vor dem Einsatz konkretisiert werden kann: Reagiert das Feedback auf die Aufgabe, den aktuellen Entwurf und die nachgewiesenen Schwierigkeiten des Lernenden? Diese Frage kann einen begrenzten Überprüfungssatz leiten, ohne das bisherige Verhalten des Lehrers zu einem unbestreitbaren Standard zu machen. Spätere, mit weniger Unterstützung durchgeführte schriftliche Arbeiten könnten ergänzende Lernnachweise liefern. FeedType bietet eine nützliche Forschungsressource zur Untersuchung adaptiven Feedbacks; Für eine Adoptionsentscheidung im Klassenzimmer oder in einer Institution sind immer noch Beweise für die Qualität und die Konsequenzen der Kommentare erforderlich, die die Lernenden tatsächlich erhalten.