Konferenzdemo: AICoFe verbindet Peer- und Selbstbewertung mit von Lehrenden geprüftem KI-Feedback
Alvaro Becerra, Alejandra Palma, Ruth Cobos, Julian Fierrez
European Conference on Technology Enhanced Learning (EC-TEL 2026), demonstration paper
500-Wörter-Zusammenfassung
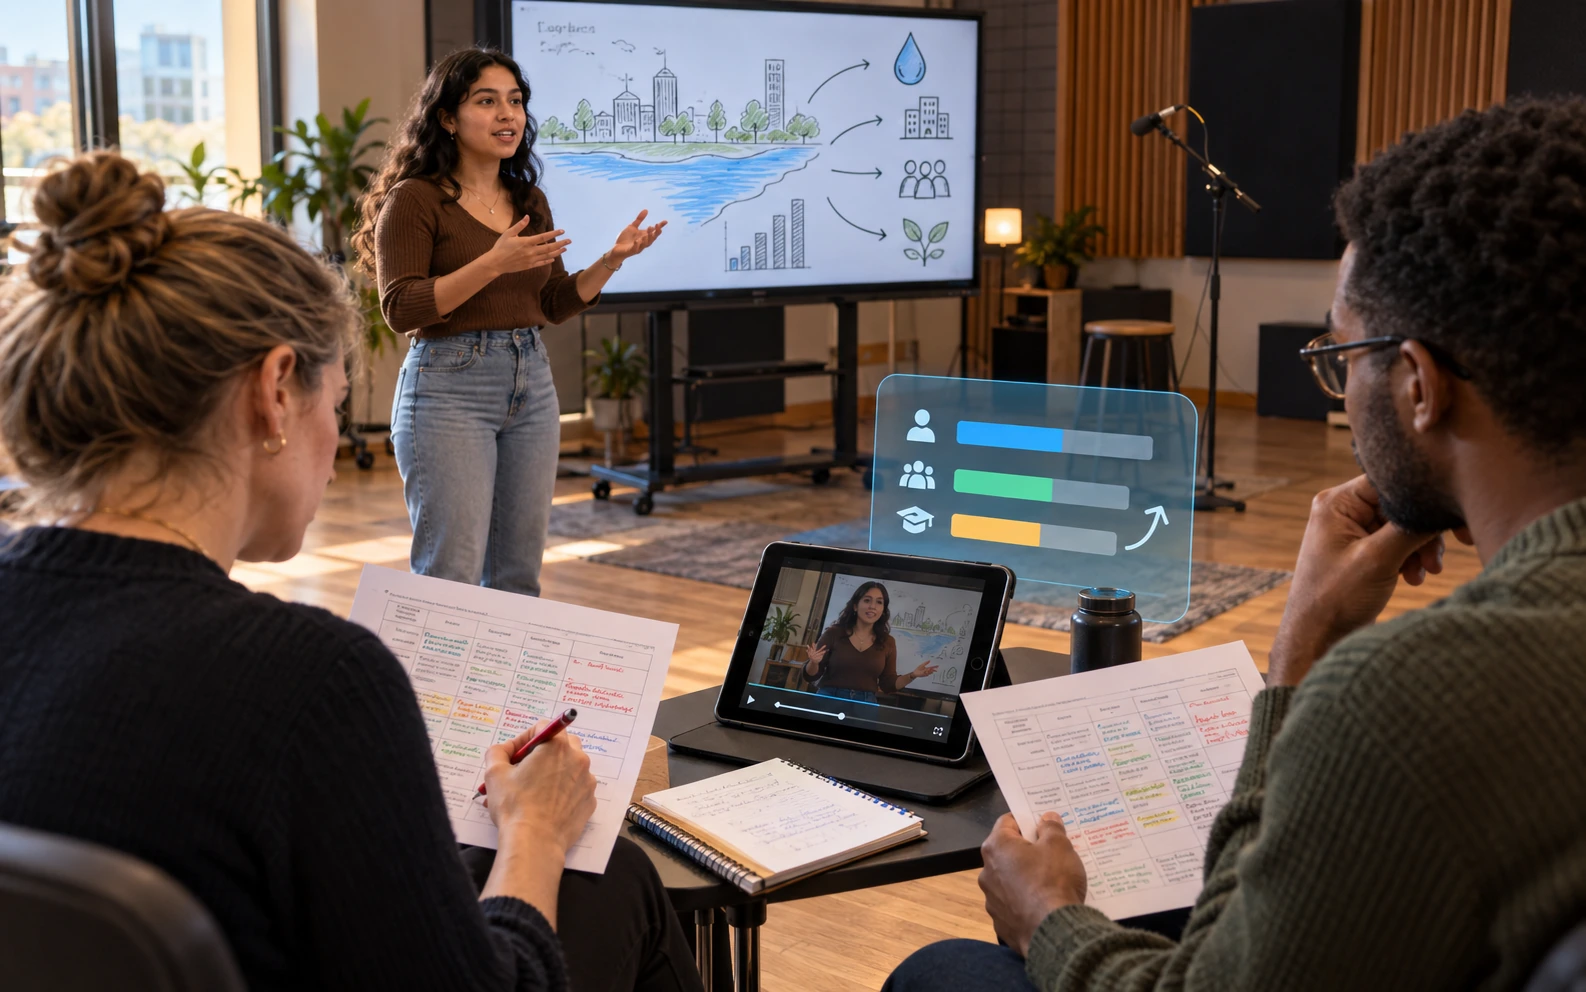
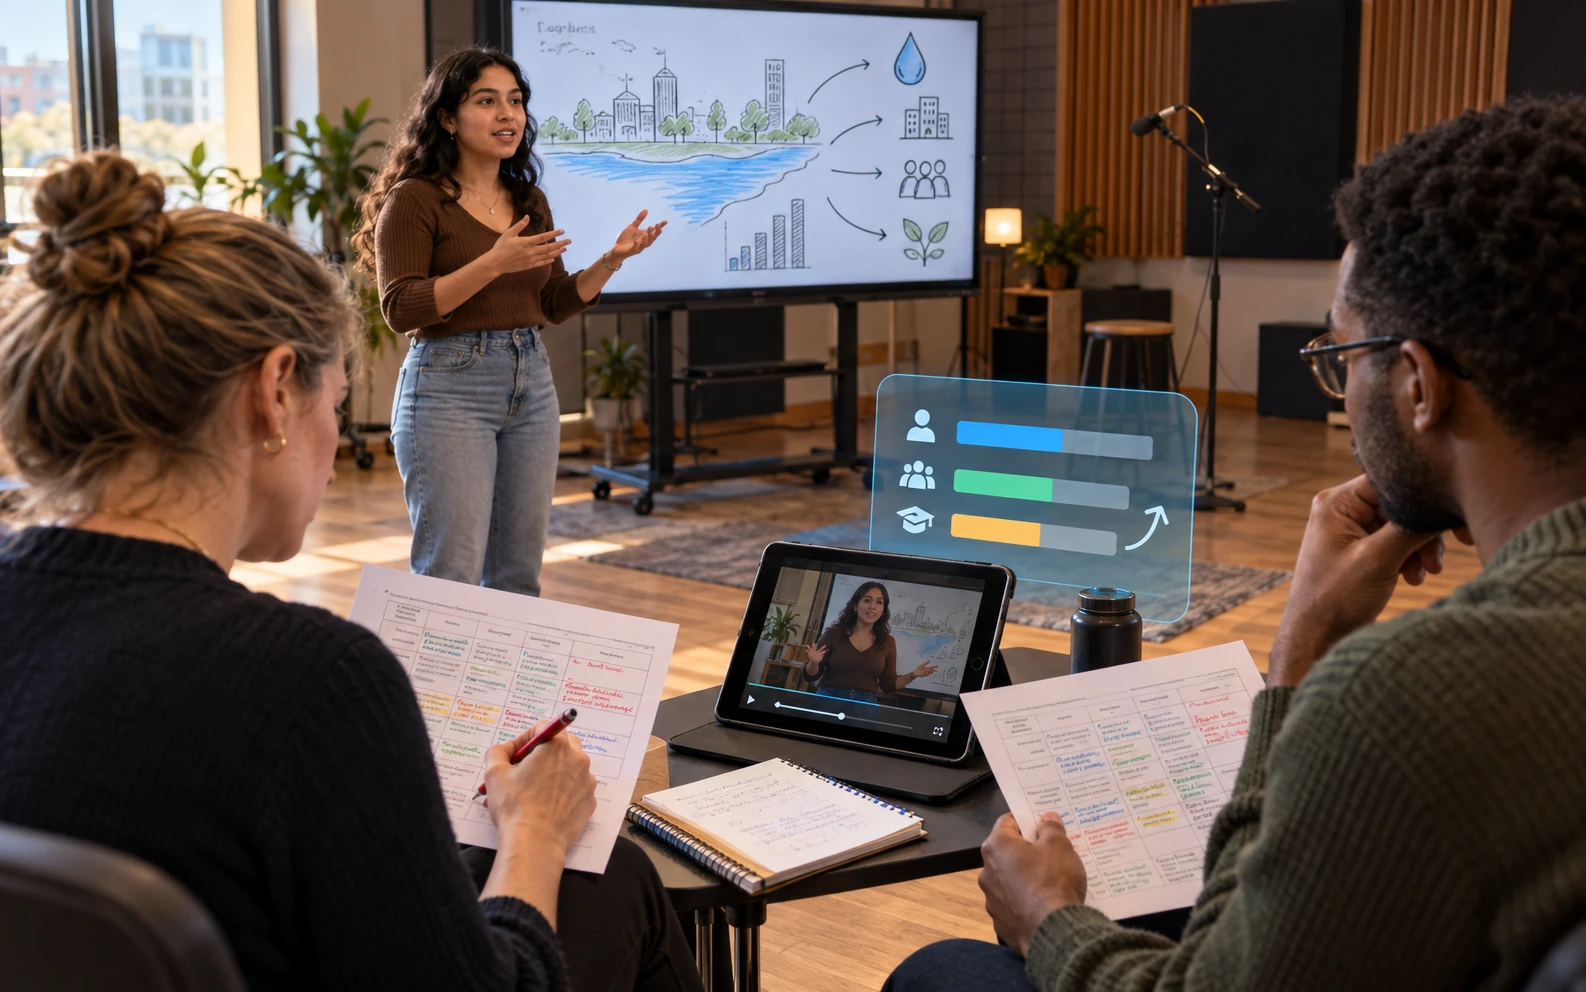
AICoFe kombiniert Peer-, Selbst- und Lehrerbewertung mit KI-gestütztem Feedback zu mündlichen Präsentationen. Die offene Autorenversion des EC-TEL-Demonstrationspapiers beschreibt einen Einsatz im Zeitraum 2024–2025 mit 46 Studenten und 19 Masterstudenten an der Universidad Autónoma de Madrid. Lehrer können generierte Kommentare auswählen, bearbeiten oder kombinieren, bevor sie sie senden. Die Zufriedenheitsbewertungen waren positiv; 31 Teilnehmer füllten den Usability-Fragebogen aus und erzielten einen durchschnittlichen Wert auf der System Usability Scale von 79,91. Diese Beobachtungen betreffen die Erfahrungen der Studierenden mit dem System, ohne eine kausale Verbesserung der Präsentationsfähigkeiten nachzuweisen.
Der Workflow vereint mehrere Perspektiven in einem Überprüfungsprozess. Die Lernenden können sich eine Aufzeichnung noch einmal ansehen und ihre eigenen Bewertungskriterien mit dem Feedback vergleichen, das sie erhalten. Die Autoren beschreiben auch, dass Entwürfe und gesendete Versionen unterscheidbar bleiben. Die geringe Anzahl an Einsätzen und Fragebogenantworten schränkt die Schlussfolgerungen ein, die daraus gezogen werden können. Die Beteiligung eines Lehrers ist Teil der berichteten Situation, daher sollten die Ergebnisse nicht als Beweis für autonomes Feedback ohne diese Vermittlung angesehen werden.
Erwägen Sie für AIEDHK eine vorgeschlagene Seminaraktivität, die sich auf eine kurze Präsentation konzentriert. Bevor der Moderator das Feedback sah, identifizierte er einen Moment, der klar schien, und einen Moment, in dem er sich ändern würde. Ein Peer würde unabhängig voneinander Beweise anhand desselben Kriteriums auswählen. Der Lehrer könnte dann den generierten Vorschlag zusammen mit diesen Beobachtungen prüfen. Ziel wäre eine Diskussion darüber, welcher Kommentar die Präsentation zutreffend beschreibt und welche Maßnahmen der Lernende realistischerweise ergreifen kann.
Beispielsweise könnte ein Lernender, der die städtische Wassernutzung erklärt, einen vagen Vorschlag erhalten, um die Klarheit zu verbessern. Eine sinnvollere Diskussion würde den Übergang lokalisieren, bei dem das Publikum die Verbindung zwischen dem Diagramm und der Behauptung verloren hat. Der Moderator könnte eine überarbeitete Erklärung einstudieren und einen neuen Zuhörer bitten, die Beziehung zu beschreiben. Dies ist ein redaktioneller Vorschlag für den Unterricht. Das Demonstrationspapier testet diese spezifische Aktivität nicht und stellt auch nicht die Wirksamkeit des Beispiels fest.
Eine Institution, die einen ähnlichen Arbeitsablauf versucht, könnte das Pilotprojekt klein halten und das Publikum und die Aufbewahrungsfrist der Aufzeichnung im Voraus festlegen. Prüfer sollten wissen, welche Kommentare von Kollegen kamen, welche generiert wurden und welche der Lehrer geändert hat. Die Lernenden sollten auch eine Möglichkeit haben, zu erklären, warum ein Kommentar ungenau oder ungeeignet ist. Diese praktischen Entscheidungen erleichtern die Überprüfung des Feedback-Prozesses und verleihen Meinungsverschiedenheiten einen pädagogischen Zweck, anstatt sie als Schnittstellenfehler zu behandeln.
Die Teilnehmer konnten ihre ersten und überarbeiteten Erklärungen zu einem Kriterium vergleichen und feststellen, was sich in ihrem Urteil nach dem Ansehen der Aufzeichnung geändert hatte. Eine kurze Darstellung würde einem Lehrer helfen, eine überlegte Reaktion auf Feedback von einer Überarbeitung zu unterscheiden, die nur vorgenommen wurde, um eine sichtbare Punktzahl zu erreichen.
Eine stärkere Bewertung könnte die nächste Präsentation prüfen, inklusive einer eigenständigen Aufgabe und klar definierten Kriterien. Es könnte die Überprüfungszeit des Lehrers, die an den generierten Kommentaren vorgenommenen Änderungen und die Frage aufzeichnen, ob die Schüler ihre gewählte Überarbeitung begründen können. Zufriedenheit und Benutzerfreundlichkeit würden neben diesen Maßnahmen weiterhin nützlich bleiben. AICoFe bietet einen konkreten Systementwurf zur Koordination von Feedback-Perspektiven; Für die Entscheidung, ob diese Koordination das Lernen verbessert, sind zusätzliche Nachweise darüber erforderlich, was die Lernenden anschließend verstehen und tun können.