Démo de conférence : AICoFe associe évaluation par les pairs, autoévaluation et retour d’IA révisé par l’enseignant
Alvaro Becerra, Alejandra Palma, Ruth Cobos, Julian Fierrez
European Conference on Technology Enhanced Learning (EC-TEL 2026), demonstration paper
Résumé de 500 mots
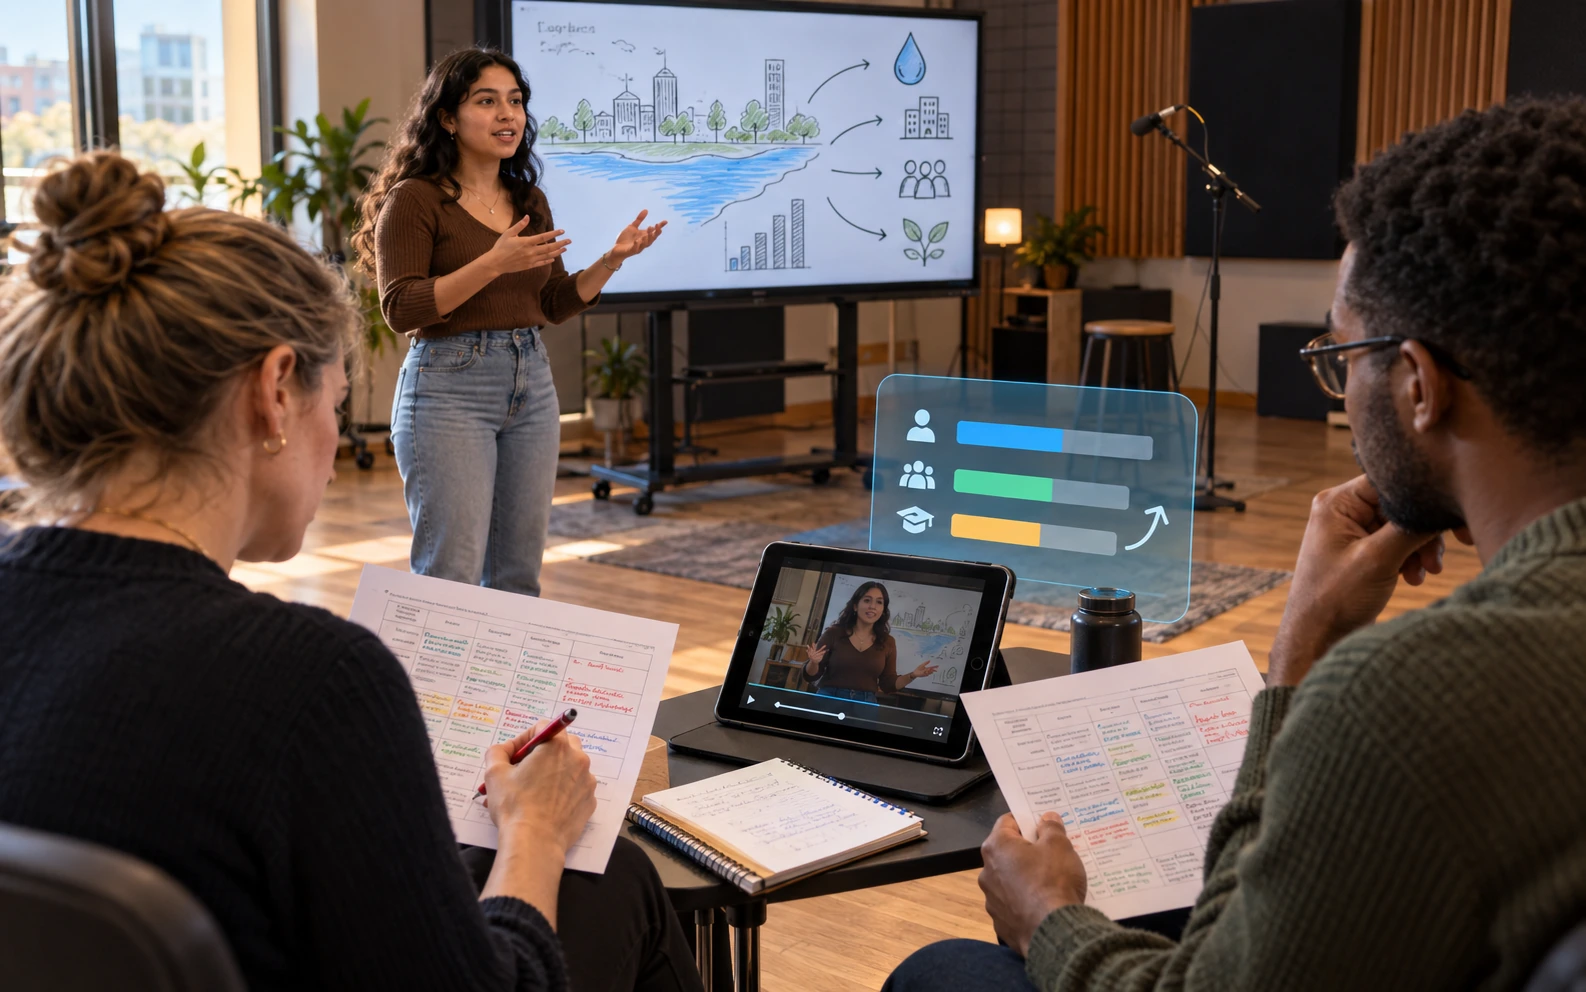
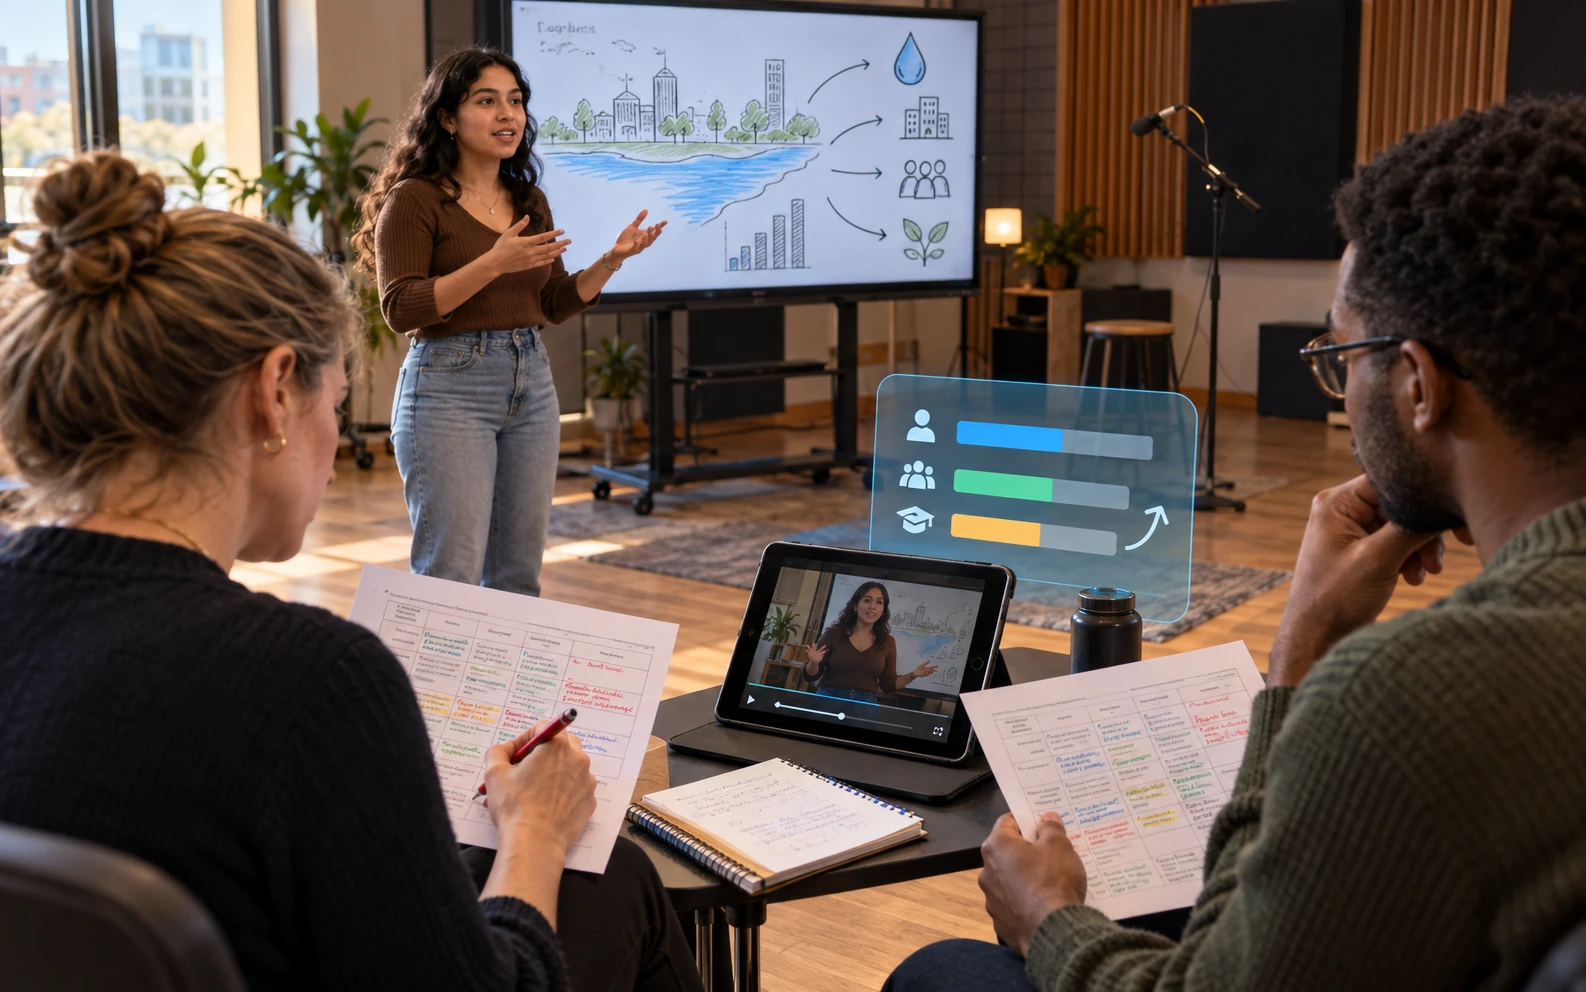
AICoFe combine l'évaluation par les pairs, l'auto-évaluation et celle des enseignants avec des commentaires basés sur l'IA sur les présentations orales. La version ouverte de l’article de démonstration d’EC-TEL décrit un déploiement 2024-2025 avec 46 étudiants de premier cycle et 19 étudiants de maîtrise à l’Universidad Autónoma de Madrid. Les enseignants peuvent sélectionner, modifier ou combiner les commentaires générés avant de les envoyer. Les taux de satisfaction étaient positifs ; 31 participants ont rempli le questionnaire d'utilisabilité, produisant un score moyen sur l'échelle d'utilisabilité du système de 79,91. Ces observations portent sur l’expérience des étudiants avec le système, sans établir d’amélioration causale des compétences de présentation.
Le flux de travail rassemble plusieurs perspectives dans un seul processus de révision. Les apprenants peuvent revoir un enregistrement et comparer leurs propres jugements de rubrique avec les commentaires qu'ils reçoivent. Les auteurs décrivent également comment distinguer les brouillons des versions envoyées. Le faible nombre de déploiements et de réponses au questionnaire limite les conclusions qui peuvent être tirées. L’implication d’un enseignant fait partie du contexte rapporté, de sorte que les résultats ne doivent pas être interprétés comme une preuve d’un retour d’information autonome sans cette médiation.
Pour l'AIEDHK, envisagez une proposition d'activité de séminaire centrée sur une courte présentation. Avant de voir les commentaires, le présentateur identifiait un moment qui semblait clair et un moment où il changerait. Un pair sélectionnerait indépendamment les preuves en utilisant le même critère. L'enseignant pourrait alors inspecter la suggestion générée parallèlement à ces observations. L’objectif serait une discussion sur le commentaire décrivant avec précision la présentation et sur l’action que l’apprenant peut entreprendre de manière réaliste.
Par exemple, un apprenant expliquant l’utilisation de l’eau en ville pourrait recevoir une vague suggestion visant à améliorer la clarté. Une discussion plus utile localiserait la transition où le public a perdu le lien entre le diagramme et l’affirmation. Le présentateur pourrait répéter une explication révisée et demander à un nouvel auditeur de décrire la relation. Il s’agit d’une proposition éditoriale en classe. Le document de démonstration ne teste pas cette activité spécifique ni n’établit l’efficacité de l’exemple.
Une institution essayant un flux de travail similaire pourrait limiter le projet pilote et définir à l’avance l’audience et la période de conservation de l’enregistrement. Les évaluateurs doivent savoir quels commentaires proviennent de leurs pairs, lesquels ont été générés et lesquels ont été modifiés par l'enseignant. Les apprenants doivent également pouvoir expliquer pourquoi un commentaire est inexact ou inapproprié. Ces décisions pratiques facilitent l’inspection du processus de feedback et donnent aux désaccords un objectif pédagogique plutôt que de les traiter comme des erreurs d’interface.
Les participants pouvaient comparer leurs explications initiales et révisées d'un critère, identifiant ce qui avait changé dans leur jugement après avoir visionné l'enregistrement. Garder ce récit bref aiderait un enseignant à distinguer une réponse réfléchie à un feedback d'une révision effectuée uniquement pour satisfaire un score visible.
Une évaluation plus approfondie pourrait examiner la prochaine présentation, comprenant une tâche indépendante et des critères clairement spécifiés. Il pourrait enregistrer le temps de révision de l'enseignant, les modifications apportées aux commentaires générés et si les étudiants peuvent justifier la révision choisie. La satisfaction et la convivialité resteraient utiles aux côtés de ces mesures. AICoFe propose une conception de système concrète pour coordonner les perspectives de feedback ; Pour décider si cette coordination améliore l’apprentissage, il faut des preuves supplémentaires sur ce que les apprenants comprennent et peuvent faire par la suite.