Artículo de congreso: FeedType examina cómo se adapta el feedback de IA durante la revisión de textos
Norah Almousa, Shayan Peyghambari Oskoui, Raquel Coelho, Gayle Rogers, Xiang Lorraine Li, Diane Litman
Proceedings of the Artificial Intelligence in Measurement and Education Conference (AIME-Con): Full Papers
Resumen de 500 palabras
Norah Almousa y sus colegas publicaron FeedType en las actas de AIME-Con, celebrado del 5 al 7 de octubre de 2026. El conjunto reúne 1.966 párrafos de tres cursos universitarios de escritura y compara feedback docente y de seis modelos de lenguaje con tres estrategias de formulación de instrucciones. Siete categorías describen el foco del feedback. Las anotaciones automáticas se contrastaron con juicios humanos. Aunque los modelos cubrieron la mayoría de las categorías, ninguno reprodujo por completo los patrones de adaptación docentes. Los análisis de las versiones del texto y del rendimiento se limitaron al curso de escritura denominado composition. El estudio analiza el comportamiento del feedback, sin probar efectos de una intervención sobre el aprendizaje.
Su contribución es una forma de preguntar en qué se centra un comentario y si ese enfoque cambia adecuadamente. Un sistema puede solicitar repetidamente una explicación incluso cuando otra respuesta sería más útil. Hacer coincidir la distribución de categorías de un docente no demostraría por sí solo que cada comentario sea preciso o útil. Los cursos del punto de referencia, las opciones de anotación y las versiones de los modelos probados también limitan hasta dónde pueden llegar los resultados más allá del entorno informado.
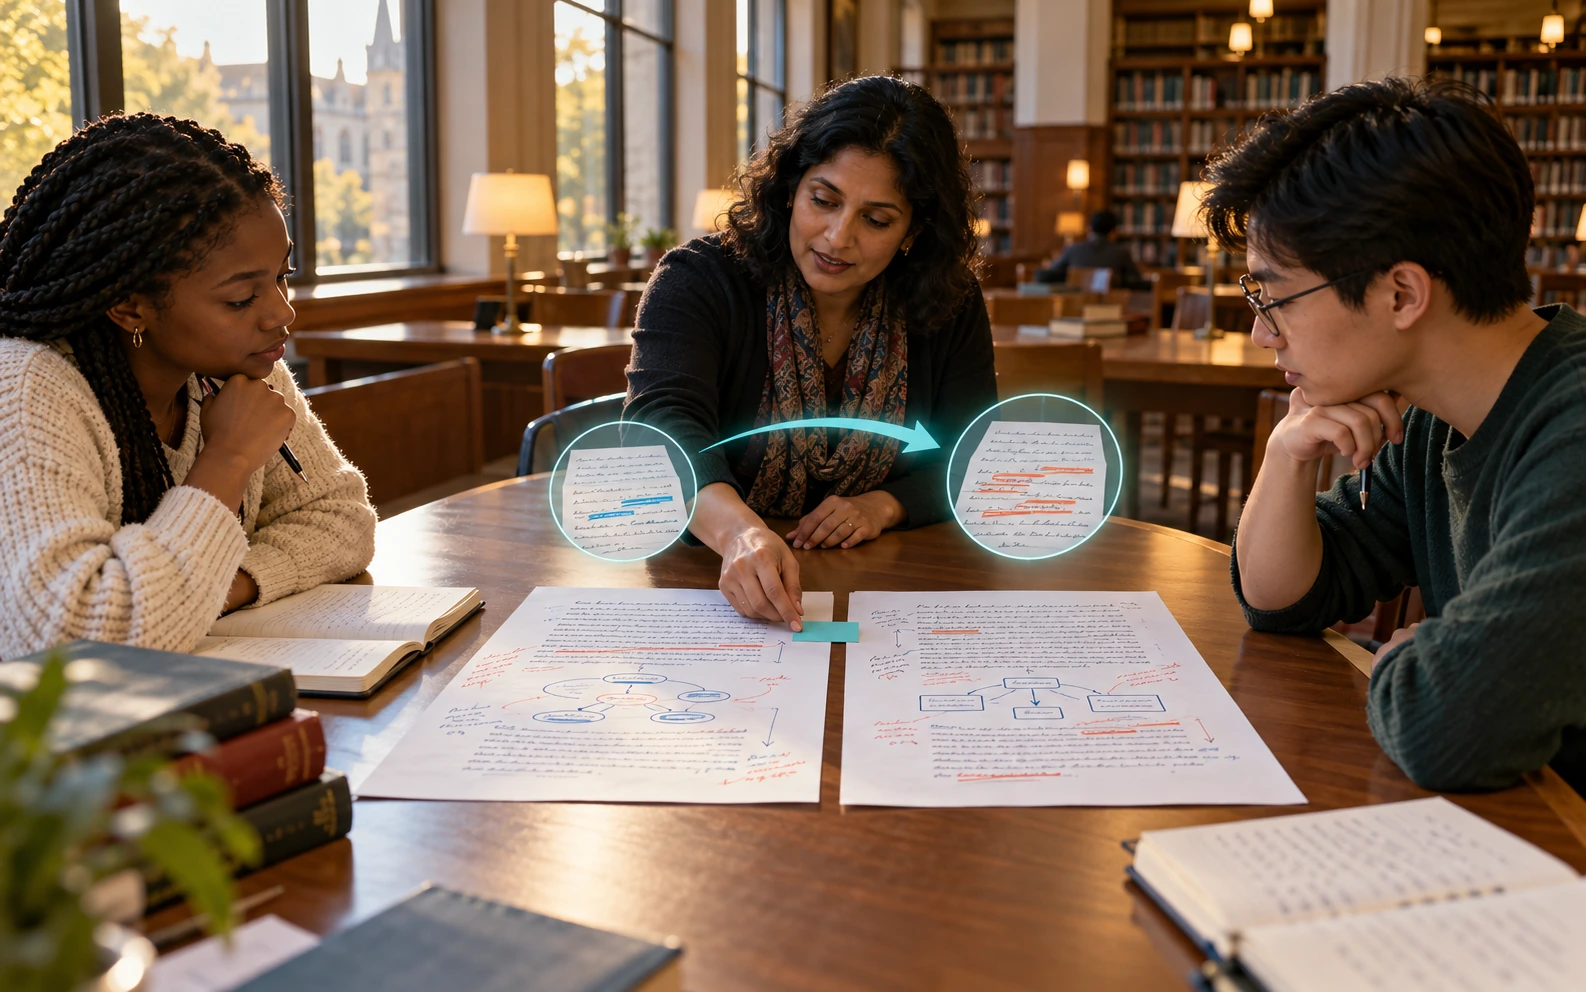
Para AIEDHK, considere una propuesta de taller de redacción basado en dos borradores del mismo párrafo. Antes de leer cualquier retroalimentación generada, el maestro identificaría el siguiente paso más importante para esa etapa de la tarea. Luego, los estudiantes podrían comparar sugerencias, localizar la evidencia textual que aborda cada una y explicar qué tema merece atención primero. Se trata de una propuesta docente editorial, más que de una actividad evaluada por el estudio de referencia.
Por ejemplo, un borrador inicial sobre un problema ambiental local podría necesitar una afirmación más clara respaldada por una fuente adecuada. Un borrador posterior ya podría establecer esa conexión y en su lugar necesitaría una explicación precisa de una calificación. Pedir más detalles en ambos casos pasaría por alto las diferentes prioridades de revisión. Los alumnos podrían explicar por qué un comentario aparentemente útil los distraería de la tarea actual, dándole al profesor evidencia de su juicio sobre la escritura.
Un piloto local podría conservar el borrador, el comentario sugerido, la acción seleccionada por el alumno y una breve razón de esa elección. Los profesores podrían inspeccionar una pequeña muestra de acuerdos y desacuerdos en lugar de asumir que aceptar más sugerencias indica un mejor aprendizaje. Los revisores también deben examinar los comentarios que identifican la categoría correcta pero proponen un cambio inadecuado. El propósito sería comprender cómo la retroalimentación apoya una decisión en un momento particular del proceso de escritura.
Una clase de escritura bilingüe podría examinar si un comentario preserva el significado pretendido por el escritor en todos los idiomas. Los estudiantes podrían defender una revisión utilizando el propósito de la tarea, mientras el maestro considera si el pulido lingüístico distrae la atención de un argumento no resuelto o de una afirmación sin fundamento.
Para los equipos de producto, el estudio sugiere una pregunta de evaluación que se puede concretar antes de la implementación: ¿la retroalimentación responde a la tarea, al borrador actual y a la dificultad demostrada por el alumno? Esa pregunta puede guiar un conjunto de revisión acotado sin convertir el comportamiento previo del profesor en un estándar incuestionable. La escritura posterior completada con menos asistencia podría proporcionar evidencia de aprendizaje complementaria. FeedType proporciona un recurso de investigación útil para examinar la retroalimentación adaptativa; una decisión de adopción en el aula o en una institución aún necesita evidencia sobre la calidad y las consecuencias de los comentarios que los estudiantes realmente reciben.